Ile RAM-u potrzebuje laptop do lokalnego uruchamiania AI?
Plik do pobrania o wielkości 3,4 GB, qwen3.5:4b-q4_K_M (LLM, czyli duży model językowy), może jeszcze dziś wieczorem odpowiedzieć na twoje pytanie na zwykłym laptopie z 16 GB pamięci, bez konta w chmurze. Wystarczy pobrać go przez Ollama, zadać jedno pytanie przy kontekście 4K i już uruchamiasz prawdziwy model AI lokalnie, na sprzęcie, który masz pod ręką. Model rozumie tekst i obrazy, a mowa tu o wnioskowaniu, nie o treningu: nikt nie uczy go niczego nowego, on po prostu odpowiada.
Naklejka "AI PC" na pudełku laptopa nie jest specyfikacją. Liczą się RAM, pamięć dostępna dla GPU, miejsce na dysku i realne wsparcie oprogramowania. 16 GB pamięci to sensowny punkt wejścia dla małych modeli AI, ale nie powód, by taki laptop od razu skreślać, ani obietnica wszystkiego, co sugeruje karta specyfikacji. Więcej pamięci daje większy kontekst i więcej swobody przy pracy na kilku rzeczach naraz. 16 GB wystarczy, żeby zacząć.
Co zużywa RAM laptopa podczas pracy z AI
Rozmiar pobieranego modelu i ilość RAM-u potrzebna po uruchomieniu to dwie różne rzeczy. Ich mylenie to najczęstszy błąd przy wyborze laptopa do AI. Te 3,4 GB pobierane dla qwen3.5:4b-q4_K_M to plik zapisany na dysku. Po załadowaniu potrzebna jest już realna pamięć operacyjna. Swoje dokłada też okno kontekstu, czyli bieżąca rozmowa, którą model trzyma w pamięci podczas odpowiedzi, nazywana KV cache. Do tego dochodzi sam silnik, system operacyjny i inne otwarte aplikacje.
Ollama domyślnie ładuje kontekst 4096 tokenów, ale możesz go zwiększyć. Uruchamianie kilku zapytań jednocześnie mnoży zapotrzebowanie na pamięć kontekstu, mniej więcej proporcjonalnie do liczby równoległych zapytań. Karta specyfikacji modelu może podawać okno kontekstu 128K albo 256K tokenów, ale traktuj to jako górny limit modelu, a nie obietnicę, że twój laptop z 16 GB pamięci udźwignie to wszystko naraz.
RAM, VRAM i pamięć zunifikowana to nie to samo
Układy Apple Silicon korzystają z pamięci zunifikowanej: CPU i GPU sięgają do tej samej puli 16, 24 albo 32 GB, więc nie ma tu osobnej pamięci graficznej, która mogłaby się skończyć. Typowy laptop z Windowsem albo Linuksem i dedykowaną kartą NVIDIA działa inaczej. RAM systemowy i własny VRAM GPU to dwie oddzielne pule, więc 16 GB RAM-u systemowego plus karta 8 GB nie tworzą jednej wspólnej puli 24 GB, z której model może korzystać bez ograniczeń.
Jeśli model nie mieści się w całości na GPU, część pracy przejmuje CPU. To częściowe przeniesienie obciążenia na procesor może sprawić, że model co prawda się uruchomi, ale będzie działał wyraźnie wolniej. Polecenie pokaże dokładnie taki podział CPU/GPU dla tego, co jest aktualnie załadowane.
Pojemność to tylko połowa obrazu. Równie ważne jest to, jak szybko ta pamięć pracuje. Apple podaje przepustowość pamięci 153 GB/s w MacBooku Air M5 i właśnie przepustowość, a nie sam rozmiar, jest jednym z powodów, dla których pamięć zunifikowana działa sprawnie, zamiast być tylko technicznie wystarczająca.
Kwantyzacja: jak model AI 9B mieści się w twoim RAM-ie
Za plikiem do pobrania o wielkości 3,4 GB stoi właśnie kwantyzacja: zapis wag modelu z niższą precyzją liczbową zmniejsza rozmiar pliku, a własny model 9B od Qwen dobrze to pokazuje. Ten sam model 9B waży przy pobieraniu 6,6 GB w wersji Q4_K_M, 11 GB w Q8_0 i 19 GB przy pełnej precyzji BF16. Ten sam model, ta sama liczba parametrów, trzy bardzo różne rozmiary pobrania. I po raz kolejny, to nadal nie to samo co ilość RAM-u potrzebna po uruchomieniu.
Niższa precyzja zwykle trochę odbija się na jakości, ale skala tego wpływu zależy od zadania, a nie od stałego procentu. Jest też jedna praktyczna rzecz, o której warto wiedzieć, jeśli chcesz zacząć właśnie od Qwen: część użytkowników zgłasza, że etap "myślenia" potrafi dodać zauważalne opóźnienie, zanim pojawi się odpowiedź, w porównaniu z modelami odpowiadającymi bardziej bezpośrednio. Dlatego najlepiej sprawdzić oba podejścia na własnych zadaniach, zamiast z góry zakładać, że jedno po prostu będzie lepsze.
Masz już MacBooka z 16 GB? Zrób to, zanim cokolwiek kupisz
Jeśli masz już MacBooka z 16 GB pamięci, zacznij od modelu 2-4B w precyzji Q4 i kontekstu 4K, zanim w ogóle pomyślisz o zakupach. Model 9B w Q4, albo coś w rodzaju Gemma 4 12B QAT, też może się załadować. To, czy tak będzie, zależy od liczby otwartych aplikacji, wielkości używanego kontekstu i tego, jak mocno komputer jest już obciążony cieplnie, więc potraktuj to jako opcję wartą sprawdzenia, a nie gwarancję.
Chcesz kupić sprzęt właśnie do tego zastosowania? MacBook Air 13 cali z układem M5 ma standardowo 16 GB pamięci zunifikowanej, z możliwością konfiguracji do 32 GB. I jeszcze jedno, zanim większy ekran zacznie kusić jako upgrade: 15-calowy Air z M5 startuje z dokładnie tymi samymi opcjami 16, 24 i 32 GB pamięci oraz z tą samą przepustowością 153 GB/s co wersja 13-calowa. Rozmiar ekranu wybierz dla wygody, nie dlatego, że liczysz na większy zapas do AI. Tego tu po prostu nie ma.

Masz już laptop z 16 GB i Windowsem albo Linuksem? Zacznij tutaj
Laptop z Windowsem albo Linuksem i 16 GB pamięci, nawet bez dedykowanego GPU, nadal może uruchomić mały model. Ollama działa natywnie w Windowsie, więc pobierz model 2-4B w Q4 i sprawdź go na CPU albo grafice zintegrowanej, zanim wydasz choćby złotówkę. Spodziewaj się większych różnic w działaniu niż na Apple Silicon: nie ma jednej stałej liczby tokenów na sekundę dla każdej maszyny, bo nikt nie przetestował wszystkich konfiguracji.
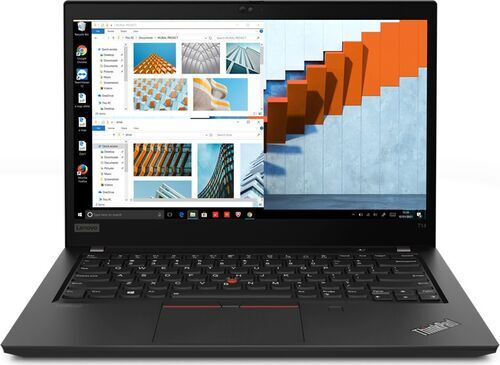
Lenovo ThinkPad T14 G2 i HP EliteBook x360 1040 G7 mają po 16 GB RAM-u i grafikę zintegrowaną, czyli dokładnie tę klasę sprzętu. Warto sprawdzić jeszcze jedną rzecz, szczególnie w starszym odnowionym laptopie, takim jak oba te modele: LM Studio w Windows x64 wymaga obsługi AVX2, czyli zestawu instrukcji, którego nie mają wszystkie starsze procesory. Zanim założysz, że dowolny laptop z tej półki uruchomi wybrane przez ciebie narzędzie, potwierdź to dla konkretnego procesora.
Pułapka w oznaczeniach GPU do laptopów: dlaczego „RTX 5070 Ti” nie odnosi się do jednego konkretnego wariantu
Laptopy z GPU NVIDIA dzielą nazwy z kartami desktopowymi, ale sama nazwa mówi mniej, niż mogłoby się wydawać. RTX 5060 Laptop GPU ma 8 GB pamięci GDDR7 i deklarowany zakres mocy od 45 do 100 W. RTX 5070 Ti Laptop GPU ma 12 GB GDDR7 i od 60 do 115 W. Wynik dla desktopowego RTX 5070 Ti znaleziony w sieci nie jest wynikiem dla laptopowego RTX 5070 Ti, niezależnie od tego, co sugeruje nazwa.
W tej samej nazwie kryje się jeszcze druga pułapka. Dwa laptopy mogą mieć "RTX 5070 Ti Laptop GPU" i mimo to działać inaczej przy dłuższym obciążeniu: cienka i lekka obudowa inaczej radzi sobie z temperaturami niż grubsza i cięższa konstrukcja, a ta sama nazwa GPU nie gwarantuje tej samej realnej wydajności po dłuższej pracy wentylatorów. Zawsze sprawdzaj dokładną wartość VRAM-u i konfigurację zasilania konkretnego laptopa, a nie tylko nazwę rodziny GPU.
Kupujesz nowego Maca? Wygodniejszy poziom to więcej pamięci zunifikowanej
Jeśli kupujesz sprzęt z myślą o regularnym uruchamianiu lokalnego AI, 24-32 GB pamięci zunifikowanej to po prostu wygodniejszy poziom w ofercie Apple: daje realny zapas na większy model, dłuższy kontekst albo zwyczajnie na trzymanie innych aplikacji otwartych podczas pracy. Wybierz 32 GB, jeśli planujesz robić to często i budżet na to pozwala.
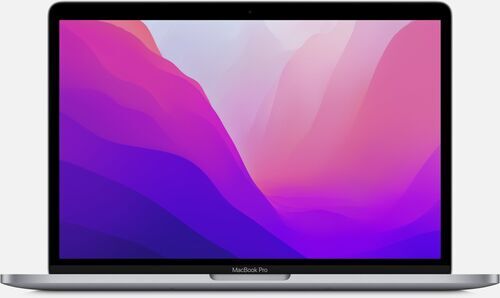
MacBook Pro 13 cali z układem M2 to konkretny odnowiony przykład sprzętu, który wykracza ponad próg wejścia 16 GB: 8-rdzeniowy CPU i 10-rdzeniowy GPU współpracują tu z pamięcią zunifikowaną do 24 GB. To starsza generacja układu niż M5 w Airze, więc właśnie limit 24 GB wyznacza tu realny pułap, a nie osobne opcje 24/32 GB dostępne w MacBooku Air M5.
Kupujesz nowy laptop z Windowsem albo Linuksem? Szukaj dedykowanego GPU
Jeśli nowy laptop z Windowsem albo Linuksem ma służyć przede wszystkim do lokalnego AI, szukaj 32 GB RAM-u systemowego i dedykowanego laptopowego GPU NVIDIA z co najmniej 8 GB własnego VRAM-u, a najlepiej 12 GB, jeśli trochę cięższy lub droższy laptop wchodzi w grę. 8 GB to realistyczny cel dla modeli 4-7B w precyzji Q4 przy umiarkowanym kontekście, ale nie zakładaj, że to automatycznie daje zapas: nawet model 9B Q4 pobierany w rozmiarze 6,6 GB może do komfortowej pracy potrzebować więcej niż gołe 8 GB, a 12 GB po prostu ułatwia testowanie w tym rozmiarze.
Dell Precision 7730 to konkretny odnowiony przykład samej idei, choć nie tych samych nowych układów co wyżej: 32 GB pamięci systemowej współpracują tu z dedykowaną kartą NVIDIA Quadro P3200 z własnym VRAM-em 6 GB. To inna generacja i klasa GPU niż obecne laptopowe RTX 5060 i 5070 Ti, ale zasada oddzielnych pul pamięci pozostaje dokładnie ta sama.

Rozsądna alternatywa: układy AMD do laptopów z dużą pamięcią
Procesor AMD Ryzen AI Max+ 395 obsługuje do 128 GB pamięci systemowej LPDDR5x, zależnie od konfiguracji konkretnego laptopa. To inna architektura pamięci, którą warto znać, ale jest tu też ważny haczyk: na liście wsparcia Linux ROCm w Ollama ten układ się pojawia, natomiast na liście ROCm dla Windowsa obecnie go nie ma.
To nie powód, żeby taki układ z góry skreślić, tylko sygnał, by przed poleceniem konkretnego laptopa sprawdzić dokładnie zainstalowaną pamięć, system operacyjny, backend GPU, sterowniki i działanie Ollama. Laptop AMD z dużą ilością pamięci potraktuj jako ciekawą alternatywną architekturę, którą warto dokładnie sprawdzić, a nie jako domyślny pierwszy wybór dla osoby zaczynającej przygodę z lokalnym AI.
Warstwa oprogramowania: Ollama i LM Studio bez technicznego żargonu
Ollama to najprostszy sposób, by uruchomić model na własnym komputerze: pobierasz model, uruchamiasz go i masz lokalny serwer odpowiadający na zapytania, bez konta w chmurze potrzebnego do pobrania modelu. To właśnie narzędzie stoi za wszystkimi przykładami tutaj.
LM Studio daje graficzną alternatywę z własną przeglądarką modeli i oknem czatu. Podaje też własne wymagania minimalne: co najmniej 16 GB RAM-u na Macu lub Windowsie, obsługa AVX2 wymagana w Windows x64 oraz zalecane 4 GB dedykowanego VRAM-u w Windowsie. Poprawna konfiguracja któregokolwiek z tych narzędzi to temat na osobny poradnik.
I jeszcze jedno, zanim uwierzysz w jedną liczbę prędkości znalezioną w sieci: oficjalne narzędzie llama-bench rozdziela szybkość przetwarzania promptu od szybkości generowania i pokazuje różnice między powtarzanymi próbami, zamiast podawać jedną liczbę. Wpis na forum z jedną wartością tokenów na sekundę rzadko mówi, który z tych dwóch pomiarów został wykonany i ile razy test powtórzono.
Na co zwrócić uwagę przy zakupie lub rozbudowie laptopa do AI
Zanim kupisz albo rozbudujesz laptop specjalnie pod lokalne AI, sprawdź konkrety, nie marketingowe hasła.
Dokładny model GPU i ilość VRAM-u. Nie sama nazwa rodziny GPU, lecz dokładny wariant laptopa i konkretna wielkość pamięci, bo ta sama nazwa może ukrywać różne wartości VRAM-u.
Czy RAM jest wlutowany, czy można go rozbudować. W niektórych laptopach pamięć dołożysz później, w wielu nowoczesnych cienkich i lekkich konstrukcjach już nie. Dobrze wiedzieć to przed zakupem.
Wolne miejsce na SSD. Modele do pobrania zajmują od mniej niż 1 GB do dużo ponad 10 GB, a rosnąca kolekcja szybko zaczyna zajmować sporo miejsca obok twoich innych plików.
Zachowanie termiczne przy dłuższym obciążeniu. Odpowiedź modelu na jedno pytanie i laptop obsługujący kilka zapytań pod rząd to dwa różne testy. Hałas wentylatorów i throttling po serii promptów powiedzą ci więcej niż jedno krótkie demo.
Wsparcie systemu i sterowników. Zanim coś założysz, sprawdź, czy dokładnie twoje połączenie backendu GPU i systemu operacyjnego ma wsparcie w Ollama lub LM Studio.
Liczba TOPS NPU na pudełku nie gwarantuje wydajności. To wskaźnik marketingowy, a nie wynik testu z silnika, którego naprawdę użyjesz. Ogólna etykieta "AI PC" nie zastępuje żadnego z powyższych sprawdzeń.
Pięć odnowionych laptopów, które mieszczą się w tych progach

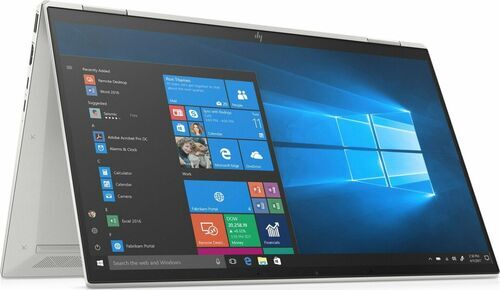
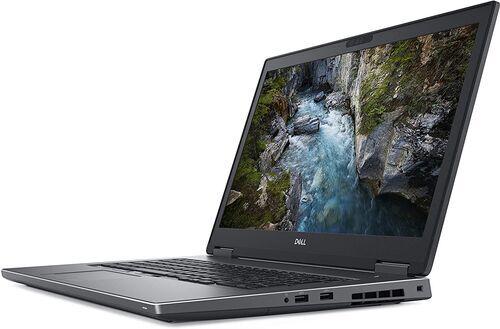
Najczęstsze pytania o uruchamianie AI na laptopie
Czy do lokalnego AI potrzebuję dedykowanego GPU?
Nie. Mały model działa na CPU albo grafice zintegrowanej w wielu laptopach z 16 GB pamięci, tylko z większymi różnicami w szybkości niż na laptopie z dedykowanym GPU. Zacznij od modelu 2-4B, zanim uznasz, że dedykowana grafika jest ci w ogóle potrzebna.
Czy 8 GB RAM-u wystarczy?
Nie na komfortowym poziomie dla modeli omawianych tutaj. 16 GB to realistyczny punkt startowy, gdy uwzględnisz, że model, jego okno kontekstu, silnik i system operacyjny korzystają z tej samej pamięci.
Czy lokalne uruchamianie modelu to to samo co jego trenowanie?
Nie. Wszystko, o czym mowa wyżej, to wnioskowanie, czyli zadawanie pytań modelowi już wcześniej wytrenowanemu. Trening buduje model od zera i wymaga znacznie mocniejszego sprzętu niż którykolwiek laptop opisany tutaj.
Czy więcej RAM-u gwarantuje szybsze odpowiedzi?
Nie. Więcej pamięci daje zapas na większe modele, dłuższy kontekst i więcej otwartych aplikacji, ale realna szybkość zależy od przepustowości pamięci, backendu GPU i konkretnego modelu, a nie tylko od samej ilości pamięci.
Czy moje dane są prywatne, gdy model działa lokalnie?
Tak, w tym sensie, że twoje prompty zostają na twoim komputerze zamiast trafiać do dostawcy chmury. Ollama domyślnie działa lokalnie na twoim laptopie i nie wysyła zapytań nigdzie indziej, chyba że świadomie skonfigurujesz dostęp do chmury.
Sprawdź to dziś wieczorem, a potem kupuj ze spokojem
Masz już laptop z 16 GB pamięci? Zainstaluj dziś wieczorem Ollama i uruchom jeden mały model, zanim wydasz choćby grosz na nowy sprzęt. Kupujesz specjalnie pod takie zastosowanie? Niech powyższa lista kontrolna i pięć opisanych przed chwilą odnowionych laptopów będą punktem wyjścia do porównania, zamiast marketingowej tabelki ze specyfikacją.
Każdy laptop na refurbed jest testowany i oceniany przed wystawieniem, więc RAM i konfiguracja, które kupujesz, są dokładnie tymi, które dostajesz. Kolejny poradnik z tej serii pokaże, jak podłączyć pierwszą aplikację do modelu, który właśnie udało ci się sprawdzić.


Zapisz się po raz pierwszy do naszego newslettera i odbierz 65 zł rabatu!
Nie przegap żadnej oferty.
Informacje na temat używania danych osobowych znajdują się w naszej Polityce prywatności
Pobierz aplikację refurbed
Dla iOS i Android


Confirm sign-up
Prawie gotowe: Wysłaliśmy Ci e-mail z potwierdzeniem
- © Refurbed Marketplace GmbH
- Dostępność
- Regulamin
- Polityka prywatności
- Nota prawna
- Informacje prawne
- European Data Act
- Cookie Policy