Najlepsze małe modele AI do pracy lokalnej: niewielki zestaw na laptop
qwen3.5:4b-q4_K_M odpowiada na pytania całkowicie offline nawet na zwykłym laptopie z 16 GB pamięci. To model znany z drugiej części cyklu i solidny asystent do różnych zadań. Nie powinien jednak odpowiadać również za przeszukiwanie twoich plików i pomoc w programowaniu. Jeśli jednym pobranym modelem próbujesz załatwić wszystko, skończysz z przeciążonym asystentem zamiast z trzema małymi modelami, z których każdy ma swoje zastosowanie.
Kontrola nad lokalnym zestawem AI oznacza świadomy wybór modelu, silnika i licencji oraz decyzję o tym, gdzie pozostają twoje dane. Jeśli nie wiesz jeszcze, ile pamięci RAM lub VRAM ma twój laptop, zacznij od poradnika o pamięci RAM potrzebnej do lokalnego AI. Jeśli nie masz zainstalowanej Ollamy, poradnik konfiguracji pierwszego lokalnego dostawcy AI przeprowadzi cię przez instalację. Dalej zakładamy, że oba kroki masz już za sobą. Pozostaje wybrać modele i sprawdzić, czy dobrze radzą sobie z twoimi zadaniami.
Najlepsze małe modele AI do pracy lokalnej według zastosowania
Przydatny lokalny zestaw obejmuje trzy różne zadania. Nie warto powierzać ich wszystkich jednemu modelowi.
Asystent ogólny do rozmów, pisania tekstów i szybkich pytań: qwen3.5:4b-q4_K_M. Plik do pobrania ma 3,4 GB. To ten sam wariant co w drugiej części cyklu.
Niewielki specjalista do węższego zadania, na przykład tworzenia odpowiedzi w ustalonym formacie lub rozumowania według określonych reguł: granite4.2:3b. Plik ma 2,2 GB, model jest objęty licencją Apache 2.0 i ukazał się w sierpniu 2026 roku. W sekcji 6 znajdziesz też modele specjalistyczne do programowania, matematyki, analizy obrazów i tłumaczenia. Możesz więc wybrać specjalistę pasującego do swojego zadania.
Model embeddingowy do przeszukiwania własnych dokumentów: embeddinggemma:300m, plik o wielkości 622 MB. Nie służy do rozmowy. Zamienia tekst na wektory, wśród których aplikacja wyszukuje potrzebne treści. Wyjaśniamy to dokładniej w sekcji 8.
Trzy pliki zajmują na dysku łącznie około 6,2 GB. Nie oznacza to, że tyle pamięci wystarczy do pracy z wszystkimi trzema naraz: po ich jednoczesnym załadowaniu laptopowi nadal może zabraknąć wolnej pamięci. W praktyce wczytuj jeden model do danego zadania, sprawdzaj go na rzeczywistym przykładzie i usuwaj te, które się nie przydają.
Co zmienia kwantyzacja?
Najłatwiej zobaczyć to na wariantach tego samego modelu. W katalogu Ollamy qwen3.5:9b-q4_K_M ma 6,6 GB, qwen3.5:9b-q8_0 ma 11 GB, a qwen3.5:9b-bf16 ma 19 GB. Ten sam zestaw wag zapisany z trzema różnymi poziomami precyzji daje trzy różne rozmiary plików do pobrania.
To rozmiary plików podane w katalogu, nie gwarancja, ile pamięci modele zajmą po załadowaniu. Niższa precyzja zmniejsza plik i często także zapotrzebowanie na pamięć podczas pracy. Ewentualna utrata jakości odpowiedzi zależy jednak od modelu, sposobu kwantyzacji i zadania. Nie zakładaj ani że jej nie będzie, ani że mniejszy plik nie wiąże się z żadnym kompromisem.
Załadowane wagi to nie wszystko. Pamięci potrzebują także okno kontekstowe i związana z nim pamięć podręczna kluczy i wartości, a do tego inne uruchomione programy. Oszczędność uzyskana dzięki kwantyzacji nie gwarantuje więc, że większy model zmieści się w pamięci. Sprawia jedynie, że warto spróbować, zanim sięgniesz po plik o pełnej precyzji.
Dwie pułapki w nazwach modeli: łatwo pobrać nie ten wariant
Dwa oznaczenia w katalogu łatwo źle odczytać. W obu przypadkach skutkiem może być pobranie innego pliku, niż zamierzasz.
Pułapka pierwsza. Na karcie Gemmy 4 E2B Google podaje 2,3 mld „efektywnych” parametrów językowych. Można się więc spodziewać małego pliku. Tymczasem wariant w Ollamie ma 7,2 GB, niemal tyle co gemma4:12b w wersji Q4, która ma 7,6 GB. Gdy oceniasz, czy laptop pomieści model, sprawdzaj rozmiar pliku do pobrania, a nie liczbę parametrów w nazwie.
Pułapka druga. Tag bez doprecyzowania może niepostrzeżenie wskazać inny wariant. Pobierz samo granite4.2, a otrzymasz model 8B o wielkości 5,3 GB, nie wariant 3B o wielkości 2,2 GB z sekcji 2. Pobierz samo qwen3-embedding, a dostaniesz model 8B o wielkości 4,7 GB zamiast wariantu 0.6B o wielkości 639 MB użytego w sekcji 8.
W obu przypadkach postępuj tak samo: pobieraj model, podając jego pełny, dokładny tag, a nie samą nazwę rodziny. Zanim uznasz, że masz wariant przeznaczony do testu, sprawdź rozmiar pobranego pliku.
Domyślne okno kontekstowe w Ollamie
Katalogowe maksimum, na przykład 128K czy 256K tokenów, mówi, ile model może teoretycznie przyjąć. Nie oznacza, że laptop z 16 GB pamięci poradzi sobie z tak dużym kontekstem.
Domyślne okno kontekstowe Ollamy ma 4096 tokenów. Możesz je zwiększyć, ale zarówno dłuższy kontekst, jak i większa liczba równoległych żądań podnoszą zużycie pamięci. Ustawienie num_ctx: 4096 z drugiej części cyklu odpowiada właśnie tej ostrożnej wartości domyślnej; nie jest przypadkowo wybraną okrągłą liczbą.
Nowy model uruchom najpierw z kontekstem od 4K do 8K tokenów i tylko jedną sesją naraz. Obserwuj przy tym zużycie pamięci. Zwiększaj kontekst dopiero wtedy, gdy zobaczysz, że wszystko działa stabilnie, nie tylko dlatego, że katalog podaje wyższą wartość.
Małe modele AI do zadań specjalistycznych: jak wybrać?
Nie ma jednego najlepszego specjalisty do wszystkiego. Liczy się twoje zadanie i kilka małych modeli, które warto na nim sprawdzić.
Programowanie: qwen2.5-coder:3b (1,9 GB) lub większy qwen2.5-coder:7b (4,7 GB). Oba są objęte licencją Apache 2.0.
Zadania matematyczne lub logiczne o ściśle określonych warunkach: phi4-mini:3.8b (2,5 GB) od Microsoftu.
Pytania dotyczące obrazów i zrzutów ekranu: gemma4:e2b (7,2 GB) lub gemma4:12b Q4 (7,6 GB). Oba modele są objęte licencją Apache 2.0 i według katalogu przyjmują tekst oraz obrazy.
Pisanie w wielu językach lub tłumaczenie: aya-expanse:8b (5,1 GB), opracowany z myślą o 23 językach.
Przy ostatnim modelu ważna jest licencja. Aya Expanse 8B jest objęty licencją CC-BY-NC-4.0 do użytku niekomercyjnego oraz dodatkowymi warunkami. Nie traktuj go więc jak modelu bez takich ograniczeń, na równi z wymienionymi wyżej wariantami na licencji Apache 2.0. Jeśli żaden z czterech obszarów nie pasuje do twojego zadania, granite4.2:3b z sekcji 2 pozostaje propozycją do ogólnego rozumowania.
Zanim zdecydujesz się na którykolwiek model, sprawdź go na własnym zadaniu. Specjalista zasługuje na miejsce w zestawie, jeśli pomaga ci osiągnąć zamierzony wynik, a nie dlatego, że zajmuje pierwsze miejsce w cudzym rankingu.
Zanim zaufasz modelowi: pięć prób, które możesz powtórzyć
Pięć krótkich prób powie ci o modelu więcej niż strona katalogu. Każdego kandydata sprawdź na tych samych pięciu zadaniach, korzystając z własnych materiałów.
1. Podsumowanie oparte na źródle. Daj modelowi notatkę liczącą 250 słów i poproś o trzy zadania do wykonania. Przy każdym ma wskazać zdanie, na którym je oparł. Zaznacz wszystkie stwierdzenia, których tekst nie potwierdza.
2. Wydobywanie danych do ustalonego formatu. Wymyśl pięć spotkań, podając nazwiska osób i daty. Poproś o JSON zawierający dokładnie wskazane przez ciebie pola, a potem porównaj wszystkie pięć wpisów z przygotowanym opisem.
3. Naprawa kodu. Daj modelowi jedną krótką funkcję, która nie przechodzi testu, oraz sam test. Sprawdź, czy po proponowanej poprawce test przechodzi. Wszystkie porównywane modele oceniaj z użyciem tego samego repozytorium i kontekstu.
4. Para językowa. Poproś osobę biegle znającą oba języki, by sprawdziła, czy tłumaczenie realistycznego akapitu zachowuje nazwy, liczby i niuanse. Nie oceniaj jakości tłumaczenia między językami wyłącznie na podstawie polecenia napisanego po angielsku.
5. Pytanie o obraz, tylko dla modeli analizujących obrazy. Pokaż wykres lub zrzut ekranu, na podstawie którego można zweryfikować odpowiedź. Upewnij się, że do modelu trafił sam obraz, a nie tylko nazwa jego pliku.
Przy każdej próbie zapisuj: zgodność ze znaną ci odpowiedzią, wykonanie instrukcji, zmyślone informacje, czas do pierwszego widocznego wyniku, łączny czas, liczbę tokenów oraz to, czy model działał na CPU czy GPU. Użyteczność i szybkość oceniaj osobno: model, który analizuje problem przed odpowiedzią, może poświęcić sporo czasu na tokeny, których nigdy nie zobaczysz.
Proste przeszukiwanie własnych dokumentów (lokalny RAG)
Model embeddingowy z sekcji 2 ma jedno zadanie: zamienia tekst na wektory, wśród których aplikacja może wyszukiwać potrzebne treści. Sam nie odpowiada na pytania.
Kolejność ma znaczenie. Najpierw dzielisz pliki na fragmenty, a model embeddingowy zamienia każdy z nich w wektor. Wektory trafiają do lokalnej bazy wektorowej. Twoje pytanie także zostaje zamienione w wektor, dzięki czemu aplikacja znajduje najbardziej zbliżone fragmenty. Dopiero wtedy model konwersacyjny odpowiada na podstawie znalezionych treści i je cytuje.
Model konwersacyjny nie był trenowany na twoich dokumentach. Widzi tylko to, co aplikacja przekaże mu podczas wyszukiwania, gdy zadasz pytanie.
Prosty przykład pozwoli sprawdzić tę zasadę bez długiej konfiguracji: zaindeksuj pięć notatek, które już masz. Zadaj jedno pytanie, na które odpowiedź znajduje się w jednej z nich, oraz drugie, na które nie odpowiada żadna. Poprawnie działający zestaw znajdzie i zacytuje właściwy fragment przy pierwszym pytaniu, a przy drugim przyzna, że nie znalazł podstaw do odpowiedzi, zamiast ją wymyślać. Trafność wyszukiwania i końcową odpowiedź oceniaj osobno.
Przed pobraniem sprawdź pełny tag modelu embeddingowego: embeddinggemma:300m albo qwen3-embedding:0.6b. Chodzi o tę samą pułapkę z niepełnymi tagami, którą opisaliśmy w sekcji 4.
Mniej aktywnych parametrów nie oznacza mniej danych do przechowania
Model oznaczony na przykład „26B A4B” wykorzystuje przy generowaniu każdego tokenu tylko część swoich parametrów. Pełny zestaw wag 26B nadal trzeba jednak gdzieś przechowywać lub przesyłać. Mniejsza liczba aktywnych parametrów nie oznacza ani mniejszego pliku, ani mniejszego zapotrzebowania na pamięć.
W całym tym poradniku nie podajemy nowych wyników własnych testów wydajności. Jeśli przytaczamy liczbę z innego źródła, na przykład relację jednej osoby o około 18,5 tokena na sekundę w nietypowej konfiguracji modelu 26B typu mixture-of-experts ze starszym procesorem i kartą graficzną z 6 GB pamięci, traktuj ją jako wynik uzyskany na tym jednym komputerze. Nie jest to wynik, którego można oczekiwać od każdego modelu z takim oznaczeniem.
Dwa laptopy, na których sprawdziliśmy zestaw
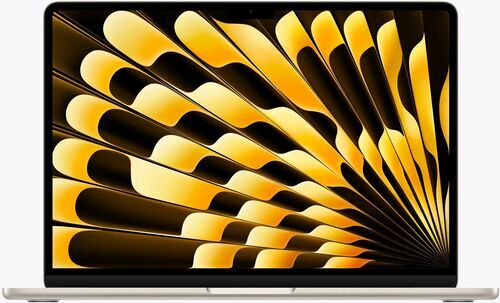
Zestaw testowaliśmy na dwóch rzeczywistych, dostępnych obecnie laptopach znanych z drugiej części cyklu: podstawowym komputerze z układem Apple Silicon oraz stacji roboczej z Windowsem i własną pamięcią graficzną. Oba są odnowione, czyli profesjonalnie przetestowane, wyczyszczone i ponownie przygotowane do użytku. Na refurbed są objęte 12-miesięczną gwarancją. Każdy z nich z zapasem wystarcza do opisanych wyżej zadań.
13-calowy MacBook Air (2026) z układem M5 ma standardowo 16 GB pamięci zunifikowanej; można go skonfigurować z maksymalnie 32 GB. Dell Precision 7730 ma 32 GB pamięci systemowej i osobne 6 GB pamięci graficznej NVIDIA (VRAM). To dwie odrębne pule, których nie należy sumować.
Nie pokazujemy tych laptopów jako zachęty do zakupu. To konkretne komputery, na których sprawdziliśmy zestaw. Możesz porównać z nimi własny sprzęt, zamiast polegać wyłącznie na marketingowej tabeli parametrów.

Licencje i porządek w zestawie modeli
Licencja dotyczy konkretnego modelu, nie całej rodziny. Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B i Gemma 4 E2B są objęte licencją Apache 2.0. Aya Expanse 8B jest objęty licencją CC-BY-NC-4.0 do użytku niekomercyjnego oraz dodatkowymi warunkami, o czym wspominaliśmy w sekcji 6. Możliwość pobrania wag, uprawnienie do korzystania z nich wynikające z licencji i „posiadanie” samego modelu to trzy różne sprawy. Sprawdzaj aktualną kartę dokładnie tego wariantu, który pobierasz, a nie tylko nazwę jego rodziny.
Niewielki zestaw wymaga regularnych porządków, nie jednorazowej selekcji. ollama rm usuwa pobrany model, który nie znalazł w nim zastosowania. Możesz na przykład użyć ollama rm aya-expanse:8b, gdy wiesz, że nie będziesz z niego korzystać. ollama ls pokazuje, co masz na dysku, a ollama ps – co jest załadowane. Katalogi się zmieniają, dlatego co jakiś czas przeglądaj swój wybór, zamiast polegać na decyzji sprzed miesięcy.
Małe modele też potrafią wymyślić fragment tekstu, przeoczyć niuans w innym języku albo napisać kod, który wygląda poprawnie, lecz nie przechodzi testu. Wszystkie propozycje potraktuj jako punkt wyjścia do własnych prób, nigdy jako zamiennik oceny specjalisty w ważnych sprawach.
Małe modele AI na własnym laptopie: pytania i odpowiedzi
Czy mogę uruchomić wszystkie trzy modele z zestawu naraz? Na laptopie z 16 GB pamięci prawdopodobnie nie będzie to wygodne. Wczytaj model potrzebny do aktualnego zadania, a potem zmień go na kolejny, zamiast trzymać w pamięci jednocześnie asystenta ogólnego, specjalistę i model embeddingowy.
Czy model embeddingowy wymaga GPU? Nie. embeddinggemma:300m jest wystarczająco mały, by przetestować go na samym CPU. Warto jednak zmierzyć czas działania, zamiast zakładać, że wynik pojawi się natychmiast.
Czy większy model zawsze daje lepszą odpowiedź? Nie. To, czy w danym zadaniu lepszy będzie model 4B czy 9B, zależy od zadania. Właśnie dlatego w sekcji 7 proponujemy pięć prób zamiast opierać się na jednym wyniku rankingu.
Czy wersja Q4 wystarczy? To zależy od zadania. Jeśli masz dość pamięci, by uruchomić oba warianty, porównaj Q4 z Q8 tego samego modelu w trzech własnych testach, tak jak przy porównaniu z sekcji 3.
Czy mogę używać Aya Expanse w projekcie komercyjnym? Nie możesz tego zakładać bez sprawdzenia warunków. Model jest objęty licencją CC-BY-NC-4.0 do użytku niekomercyjnego oraz dodatkowymi warunkami, więc przed przyjęciem innego założenia sprawdź jego aktualną kartę.
Czy po pobraniu model embeddingowy potrzebuje internetu? Nie. Podobnie jak pozostałe modele z tego zestawu działa offline, gdy jego wagi są już na dysku.
Teraz twoja kolej: zainstaluj, przetestuj i zostaw przydatne modele
Na laptopie dobranym z pomocą pierwszej części cyklu i skonfigurowanym według drugiej zainstaluj asystenta 4B oraz jednego specjalistę pasującego do twojego zadania. Przeprowadź własną wersję testu z sekcji 7, ograniczoną do trzech pytań. Zostaw model, który ci pomaga, a drugi usuń poleceniem ollama rm. Zakup większej ilości pamięci rozważ dopiero wtedy, gdy rzeczywiste zadanie, a nie tabela parametrów, pokaże, że to właśnie pamięć stanowi ograniczenie.
Na tym kończy się nasz trzyczęściowy cykl. Jeśli twój obecny laptop ma za mało pamięci do tych zadań, możesz zacząć od przejrzenia kategorii laptopów.

Zapisz się po raz pierwszy do naszego newslettera i odbierz 65 zł rabatu!
Nie przegap żadnej oferty.
Informacje na temat używania danych osobowych znajdują się w naszej Polityce prywatności
Pobierz aplikację refurbed
Dla iOS i Android


Confirm sign-up
Prawie gotowe: Wysłaliśmy Ci e-mail z potwierdzeniem
- © Refurbed Marketplace GmbH
- Dostępność
- Regulamin
- Polityka prywatności
- Nota prawna
- Informacje prawne
- European Data Act
- Cookie Policy